Od pliku płaskiego do raportu w Power BI. Budowa hurtowni danych w Microsoft Fabric krok po kroku.
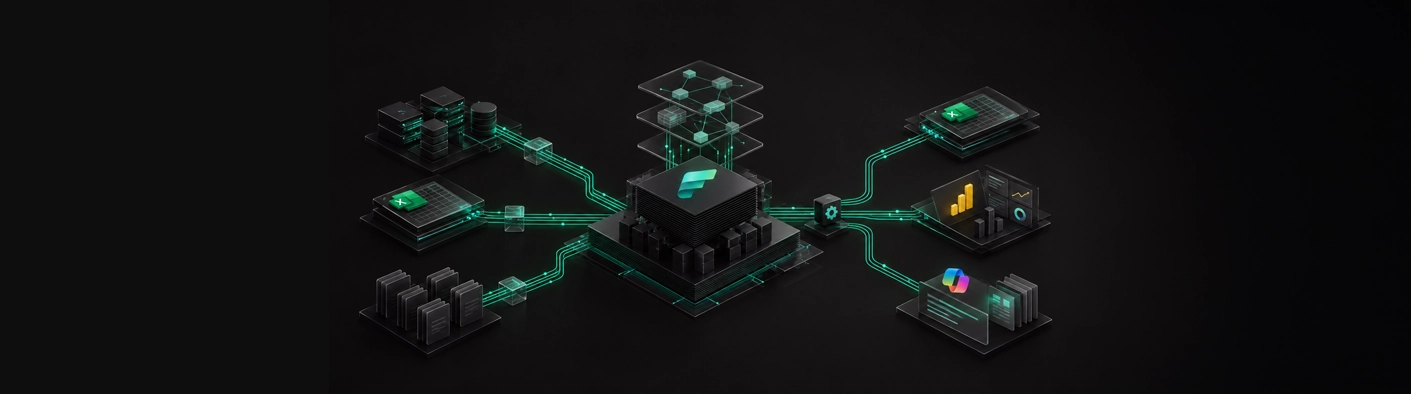
Budowa hurtowni danych w Microsoft Fabric sprowadza się do sześciu kroków: utworzenia Lakehouse, podłączenia źródeł danych, zdefiniowania transformacji w Dataflow, zbudowania modelu semantycznego, wyboru sposobu konsumpcji danych oraz automatyzacji odświeżania. Całość można wykonać w trybie low-code, bez pisania kodu, a pracę definiuje się raz: od tego momentu rozwiązanie działa samoczynnie.
W tym artykule przechodzimy przez wszystkie sześć kroków na realnym scenariuszu, który pokazaliśmy na naszym webinarze o hurtowni danych 2.0. Jeśli chcesz najpierw zrozumieć, czym podejście 2.0 różni się od klasycznej architektury, zacznij od artykułu o hurtowni danych 2.0.
Punkt wyjścia: sytuacja przed zmianą
Bohaterem scenariusza jest analityk odpowiedzialny za sprzedaż, który cyklicznie łączy dane z kilku miejsc:
System ERP, w tym przypadku Microsoft Dynamics 365, zrzuca automatycznie eksporty faktur i transakcji, osobny plik za każdy okres. Pliki lądują w folderze w chmurze. Do tego dochodzi plik budżetowy prowadzony w Excelu, z budżetem ułożonym po kluczu rok-miesiąc i grupie produktowej. A ponieważ w grupie działa druga spółka, z której danych analityk nie ma bezpośrednio w swoim systemie, jej wyniki spływają w postaci kolejnych plików płaskich.
Do tej pory łączenie tych źródeł odbywało się ręcznie w Excelu: doklejanie eksportów, WYSZUKAJ.PIONOWO, klucze budowane formułami, tabela przestawna. Koszty tej pracy opisaliśmy w artykule o Excelu jako hurtowni danych. Teraz pokazujemy, jak ten sam proces wygląda po przeniesieniu do Microsoft Fabric.
Krok 1: Lakehouse, czyli fundament hurtowni
Pracę zaczynamy od utworzenia Lakehouse. To centralne miejsce, w którym będą żyły wszystkie dane: nasza mała hurtownia. Jeśli szukasz analogii ze świata Excela, potraktuj Lakehouse jak zbiorczy skoroszyt w chmurze, a schemat, który tworzymy w nim na start, jak folder porządkujący tabele, podobnie jak zakładki porządkują arkusze.
Różnica jest taka, że ten skoroszyt nie ma limitu wierszy, nie zwalnia przy dużych zbiorach i nie da się go uszkodzić przez przypadkowe nadpisanie.
Krok 2: podłączenie źródeł bez kopiowania danych
Dynamics 365 przez Fabric Link i shortcuty
Do tabel źródłowych systemu ERP podłączamy się mechanizmem shortcutów. Fabric Link udostępnia tabele Dynamics 365 w środowisku Fabric, a shortcut tworzy do nich odnośnik: mamy pełny wgląd w dane o fakturach, transakcjach, klientach i produktach, ale fizycznie nie kopiujemy ich do hurtowni. Działa to jak skrót na pulpicie do aplikacji: skrót nie jest aplikacją, tylko do niej prowadzi.
Tabele shortcutowe rozpoznasz w Lakehouse po ikonie z agrafką. Po kliknięciu widzisz zwykły widok tabelaryczny, dokładnie tak, jakbyś przeglądał dane w arkuszu.
Plik budżetowy
Excel z budżetem wgrywamy bezpośrednio do Lakehouse. Jeśli budżet jest aktualizowany raz na kwartał albo rzadziej, wystarczy podmieniać plik ręcznie; ten proces również da się zautomatyzować, ale przy tak rzadkich zmianach ręczna podmiana to praca na minuty.
Dzienne partie z Blob Storage
Eksporty z drugiej spółki spływają do Blob Storage, czyli folderu w chmurze Azure. Podłączamy się do niego bezpośrednio. Warto dodać, że Fabric ma ponad sto konektorów do różnych źródeł, więc równie dobrze mógłby to być SharePoint, baza SQL czy źródła spoza ekosystemu Microsoft.
Po tym kroku wszystkie źródła są dostępne z jednego miejsca. Nic jeszcze nie zostało połączone, ale skończyło się szukanie danych po plikach i folderach.
Krok 3: transformacja w Dataflow
Teraz odtwarzamy całą logikę, którą analityk wykonywał ręcznie, tyle że definiujemy ją raz. Służy do tego Dataflow: narzędzie, które użytkownicy Power BI rozpoznają natychmiast, bo działa jak Power Query, tylko z większymi możliwościami.
Łączenie plików z folderu. Opcja Combine skleja wszystkie pliki z folderu w jedną tabelę. Kluczowe jest to, że Dataflow patrzy na folder, a nie na listę konkretnych plików: gdy spłynie kolejna partia danych, zostanie uwzględniona automatycznie, bez żadnego klikania. Jeżeli któryś plik miałby inną strukturę kolumn, transformacja zgłosi błąd, zamiast po cichu przetwarzać złe dane.
Rozróżnienie spółek i sklejenie danych. Do danych każdej spółki dodajemy kolumnę z jej nazwą, która później posłuży jako filtr, a następnie opcją Append podklejamy dane obu spółek pod siebie. Od tej chwili sprzedaż z Polski i z Wielkiej Brytanii żyje w jednej tabeli.
Wybór kolumn zamiast ich ukrywania. Eksporty z ERP mają ponad sto kolumn, a do analizy potrzeba kilkunastu. Krokiem Choose Columns wybieramy te właściwe. W przeciwieństwie do ukrywania kolumn w arkuszu nic nie ginie: krok można w każdej chwili edytować albo usunąć i wrócić do pełnego widoku.
Merge zamiast WYSZUKAJ.PIONOWO. Grupę klienta z nagłówków faktur dociągamy do transakcji funkcją Merge, wskazując kolumny łączące: identyfikator sprzedaży, numer faktury i datę. Nie trzeba budować sztucznych kluczy przez sklejanie kolumn. Bonus: przy łączeniu Fabric od razu pokazuje, czy dopasowanie jest jeden do jednego. Jeśli transakcji byłoby więcej niż nagłówków, zobaczymy to natychmiast i wiemy, że coś jest nie tak z danymi albo że spóźnia się któraś partia.
Porządki w typach danych i dynamiczne filtry. Kolumnę daty z niepotrzebną godziną zamieniamy na czystą datę, co poprawia wydajność. Do tego ustawiamy dynamiczny filtr okresu: zamiast zaznaczać rok na sztywno, wybieramy warunek typu bieżący i poprzedni rok. Niezależnie od tego, kiedy otworzysz raport, zakres danych będzie właściwy.
Applied Steps: dokumentacja sama z siebie. Każdy z powyższych kroków zapisuje się na liście Applied Steps po prawej stronie. To pełna historia transformacji: widać, co się dzieje z danymi, w jakiej kolejności, i można dodać komentarz do każdego kroku. Nowa osoba w zespole nie dostaje pliku-zagadki, tylko udokumentowany proces.
Na koniec wskazujemy Data Destination, czyli miejsce docelowe: nasz Lakehouse. Po odświeżeniu transformacji w hurtowni pojawiają się gotowe tabele: zunifikowana sprzedaż, budżet, klienci i produkty.
Krok 4: model semantyczny
Dane są już połączone i czyste, ale to wciąż tabele, które ze sobą nie rozmawiają. Model semantyczny to warstwa, która układa je w logiczną strukturę.
Relacje między tabelami. Tabele klientów i produktów łączymy relacjami z tabelami sprzedaży i budżetu. Dzięki temu jeden filtr, na przykład grupa klienta, działa jednocześnie na dane rzeczywiste i budżetowe. Unikamy przy tym duplikacji danych i przyspieszamy działanie całości.
Star Schema. Docelowy układ to schemat gwiazdy: centralna tabela faktów, w naszym przypadku sprzedaż, otoczona tabelami wymiarów, czyli klientami, produktami i kalendarzem. To najbardziej wydajny układ dla silnika analitycznego Power BI.
Tabela kalendarza. Brakującym puzzlem jest wspólna oś czasu. Bez tabeli kalendarza sprzedaż i budżet nie mają jak spotkać się na jednym wykresie, a na osi czasu powstają dziury w dniach bez sprzedaży. Tutaj po raz pierwszy sięgamy po Copilota: prostym poleceniem generujemy dynamiczną tabelę kalendarza z kolumnami roku, kwartału, miesiąca i dnia, od zadanej daty do dziś. Drugim poleceniem dokładamy kolumnę klucza rok-miesiąc w formacie zgodnym z plikiem budżetowym. Koniec ze sztuczkami typu mnożenie roku razy sto. Tabela kalendarza zasługuje zresztą na osobny tekst i taki artykuł znajdziesz na naszym blogu.
Miary. Na koniec definiujemy kalkulacje: sumy sprzedaży, budżetu, wykonania. To odpowiedniki sum, które w arkuszu liczyło się formułami, tyle że zdefiniowane raz i dostępne w każdym raporcie.
Krok 5: konsumpcja danych, czyli trzy drogi do tego samego źródła
Analyze in Excel. Dla przyzwyczajonych do arkusza: jedno kliknięcie generuje Excela w chmurze z tabelą przestawną podpiętą do modelu semantycznego. Ten sam pivot co zawsze, tylko że po kliknięciu Refresh dane zaciągają się aktualne, bez podklejania czegokolwiek. Co ważne, to opcja, a nie krok wymagany: kto nie potrzebuje Excela, po prostu go pomija.
Raport Power BI w trybie Direct Lake. Do modelu podłączamy się z Power BI w trybie Direct Lake, czyli na żywo, bez importowania danych do projektu. Budujemy raport z interaktywnymi wykresami, filtrami po spółce i grupie klienta oraz porównaniami okres do okresu, a następnie publikujemy go do obszaru roboczego. Różnicom między trybami Direct Lake i Import poświęcimy osobny artykuł.
Copilot. Trzecia droga jest najszybsza: Copilot potrafi wygenerować stronę raportu na bazie modelu semantycznego oraz przygotować pisemne podsumowanie wyników dla zespołu, z liczbami, trendami i interaktywnymi wizualizacjami. Wyniki zawsze warto sprawdzić, ale jako punkt startowy przed poniedziałkowym spotkaniem to oszczędność liczona w godzinach.
Krok 6: automatyzacja odświeżania
Ostatni element to harmonogram. Tworzymy pipeline, który raz dziennie odświeża transformację, czeka na synchronizację danych i odświeża model semantyczny, a w razie błędu wysyła powiadomienie na Microsoft Teams. Szkielet takiego potoku również potrafi przygotować Copilot na podstawie polecenia w języku naturalnym. Szczegóły orkiestracji, harmonogramów i wyzwalaczy zdarzeniowych opisujemy w osobnym artykule o automatyzacji odświeżania danych.
Od tego momentu cała praca, którą analityk wykonywał ręcznie po każdym okresie, dzieje się sama.
Efekt: praca wykonana raz, rozwiązanie działa stale
Warto podkreślić jedno: w całym procesie nie napisaliśmy praktycznie ani linijki kodu. To scenariusz w pełni low-code, dostępny dla użytkownika biznesowego.

Gdzie w tym wszystkim partner wdrożeniowy
Najwięcej doświadczenia wymaga krok 4, czyli model semantyczny: dobrze zaprojektowane relacje, wydajny układ gwiazdy, przemyślane miary i zasady dostępu do danych. To etap, na którym zespół Power Center w ANEGIS robi największą różnicę. Naszym celem jest przy tym pozostawienie Was w pełni samodzielnymi: my budujemy fundament, a raporty, analizy i pracę z Copilotem prowadzicie już sami, na własnych, zawsze aktualnych danych.
Jeśli chcecie zobaczyć ten proces na swoich danych, zapraszamy do kontaktu. Taki warsztat, jak opisany powyżej, przeprowadzamy również na środowisku klienta.
FAQs
Ile trwa budowa hurtowni danych w Microsoft Fabric?
Podstawowy scenariusz, obejmujący podłączenie kilku źródeł, transformacje, model semantyczny i raport, można zbudować w kilka dni roboczych. Na webinarze pokazaliśmy skróconą wersję tego procesu w niecałą godzinę. Czas rośnie wraz z liczbą źródeł i złożonością logiki biznesowej, ale kluczowa cecha pozostaje ta sama: pracę wykonuje się raz, a rozwiązanie działa stale.
Czy do budowy hurtowni w Fabric trzeba umieć programować?
Nie. Opisany scenariusz jest w pełni low-code: transformacje buduje się w interfejsie Dataflow, znanym użytkownikom Power Query, a relacje w modelu tworzy się przeciąganiem kolumn. Kod, na przykład SQL, PySpark czy język R w notebookach, jest dostępny dla zaawansowanych scenariuszy, ale nie jest wymagany.
Czy dane z Dynamics 365 trzeba kopiować do hurtowni?
Nie. Mechanizm Fabric Link wraz z shortcutami daje dostęp do tabel Dynamics 365 bez fizycznego kopiowania danych. Hurtownia widzi zawsze aktualne dane źródłowe, a organizacja unika duplikacji zbiorów i kosztów ich synchronizacji.
Co się stanie, gdy w plikach źródłowych zmieni się struktura kolumn?
Dataflow kontroluje strukturę łączonych plików. Jeśli nowy plik ma inną strukturę niż pozostałe, transformacja zgłosi błąd zamiast przetworzyć niespójne dane. W połączeniu z powiadomieniami na Microsoft Teams zespół dowiaduje się o problemie natychmiast, a nie po opublikowaniu błędnego raportu.


Szukasz partnera Microsoft? Porozmawiajmy o Twoim projekcie
Pracuj z zespołem, który zrealizował wdrożenia i projekty dla dziesiątek firm. Umów rozmowę wstępną i sprawdź:
Jak Dynamics 365 dopasować do procesów Twojej firmy, a nie odwrotnie
Które obszary warto zautomatyzować, żeby odzyskać czas i obniżyć koszty
Jak wygląda wdrożenie z Anegis krok po kroku: od analizy po wsparcie po starcie