Microsoft Data Archive w D365 F&O: jak działa, jakie ma ograniczenia i kiedy się nie uruchomi
Wśród czterech dróg redukcji konsumowanej przestrzeni w Dynamics 365 Finance & Operations, obok zadań czyszczących, zarządzania indeksami i odchudzania sandboxów, archiwizacja jest drogą najbardziej „oficjalną”: Microsoft dostarcza do niej dedykowany dodatek Data Archive. Brzmi to jak koniec tematu, jest narzędzie, wystarczy włączyć. W praktyce właściwe wdrożenie archiwizacji to zadanie co najmniej nietrywialne: klienci zazwyczaj potrzebują wsparcia zarówno w implementacji, jak i w określeniu wpływu mechanizmu na funkcjonowanie procesów biznesowych, a sam dodatek ma ograniczenia, które w części środowisk uniemożliwiają jego użycie w ogóle. Ten artykuł uczciwie rozbiera Data Archive: jak działa, gdzie się sprawdza, gdzie się zatrzymuje, i co robić, gdy się zatrzyma.
Dla kogo: środowiska produkcyjne działające ponad dwa lata
Adresatem archiwizacji są przede wszystkim organizacje, których środowisko produkcyjne działa ponad dwa lata. To nie jest granica formalna, lecz praktyczna: konstrukcja mechanizmu operuje na danych w wieku liczonym w latach, więc młodsza instalacja po prostu nie ma jeszcze czego archiwizować. Dojrzała, przeciwnie: to w niej dane historyczne urosły do rozmiarów, przy których ani zadania czyszczące, ani porządki w indeksach nie wystarczą, bo znaczna część ciężaru to pełnoprawne dane biznesowe, których nie wolno skasować, a które nie muszą już mieszkać w tabelach operacyjnych.
Trzy kroki mechanizmu
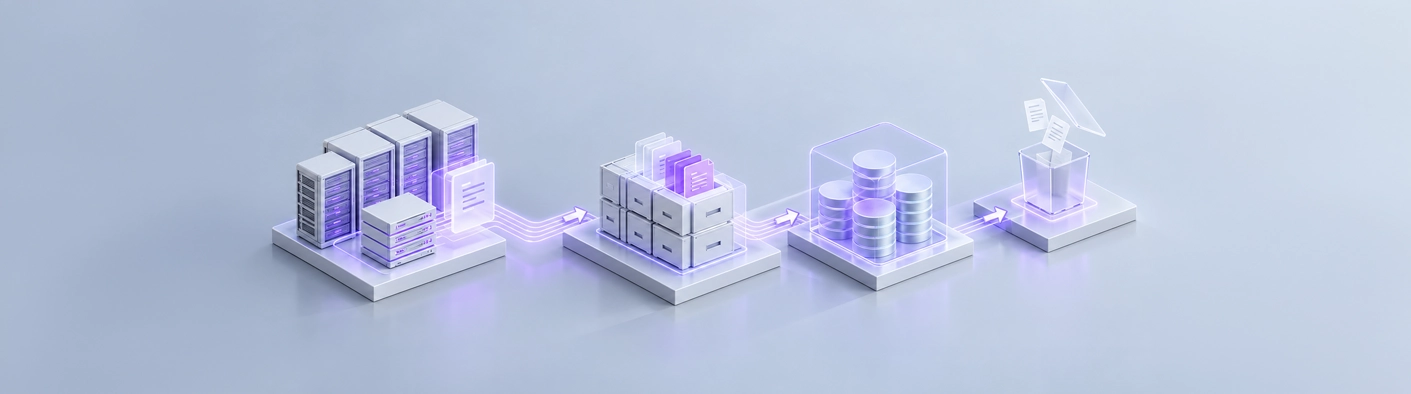
Data Archive z perspektywy Microsoftu jest skonstruowany jako sekwencja trzech kroków, z których każdy obsługuje inną fazę życia danych.
Krok 1: tabele live → tabele Archive (dane 2–5 lat)
Pierwszy krok to przeniesienie danych z tabel rzeczywistych, operacyjnych, nazywanych live, do tabel z sufiksem Archive. Dane opuszczają struktury, po których na co dzień poruszają się procesy i użytkownicy, ale pozostają w środowisku. Ten krok jest dedykowany orientacyjnie dla danych w wieku od dwóch do pięciu lat: wciąż na tyle bliskich, że bywają potrzebne, już na tyle odległych, że nie muszą obciążać tabel operacyjnych.
Krok 2: Archive → Long Term Data Retention w Dataverse (5–N lat)
Drugi krok przenosi dane z tabel Archive do mechanizmu Dataverse o nazwie Long Term Data Retention, warstwy zaprojektowanej do wieloletniego przechowywania. To miejsce dla danych w wieku od pięciu lat do granicy N: dostępnych na potrzeby raportowania i kontroli, ale poza środowiskiem operacyjnym.
Krok 3: czyszczenie (N+), i magiczne N, inne dla każdego obszaru
Trzeci krok to wyczyszczenie danych najstarszych, tych, które przekroczyły granicę N. I tu pojawia się najważniejsza decyzja całego procesu: owo magiczne N, czyli data graniczna, jest specyficzne dla każdego klienta i dla każdego obszaru danych osobno. Część organizacji musi przechowywać dane księgowe przez pięć czy siedem lat, w zależności od konkretnych wymagań, ale może też potrzebować przechowywać wybrane obszary dłużej. Wyznaczenie N nie jest więc czynnością techniczną, lecz decyzją na styku księgowości, biznesu i prawa, i żaden dodatek nie podejmie jej za organizację.
Ograniczenia, o których dokumentacja mówi cicho
Uczciwy obraz Data Archive wymaga trzech zastrzeżeń, bo to one decydują, czy mechanizm w danym środowisku zadziała.
Ograniczona pula scenariuszy, i tempo ich rozwoju
Data Archive funkcjonuje dla ograniczonej puli standardowych scenariuszy archiwizacji. Grupa produktowa Microsoftu stale nad nimi pracuje i stara się dodawać kolejne do puli, kierunek jest więc dobry, ale w danym momencie mechanizm obejmuje to, co obejmuje. Jeżeli ciężar konkretnego środowiska leży w obszarach, dla których scenariusza jeszcze nie ma, standardowa archiwizacja tego ciężaru nie zdejmie.
Progi rekordów: 100–200 milionów, powyżej których scenariusz się nie wykona
Drugie ograniczenie jest bardziej podstępne, bo uderza dokładnie tam, gdzie potrzeba jest największa. Rozwiązanie funkcjonuje dla ograniczonej puli rekordów w konkretnych tabelach, należy to rozumieć jako progi rzędu stu czy dwustu milionów rekordów. Po przekroczeniu progu dany scenariusz po prostu się nie uruchomi, nie wykona. Paradoks jest oczywisty: tabele, które najbardziej potrzebują archiwizacji, to te największe, a to właśnie one potrafią być poza zasięgiem mechanizmu. Organizacja, która odkładała temat latami, może więc odkryć, że standardowe narzędzie jest już dla niej za małe.
Włączyć pstryczek łatwo, oszacować skutki trudno
Trzecie zastrzeżenie dotyczy procesu wdrożenia. Jakkolwiek można włączyć poszczególne scenariusze i zobaczyć, co się stanie, tak oszacowanie wpływu i dostosowanie procesów biznesowych do zaaplikowanych zmian jest zadaniem zauważalnie cięższym. Dane, które opuszczą tabele operacyjne, przestaną być widoczne tam, gdzie dotąd były, a to potrafi zaskoczyć raporty, integracje i przyzwyczajenia użytkowników. Odpowiedzialne wdrożenie wymaga więc przejścia procesów przed uruchomieniem, nie po pierwszym zgłoszeniu zdziwionego użytkownika.
Kiedy Data Archive wystarczy, a kiedy potrzebny jest substytut
Rozstrzygnięcie sprowadza się do dwóch pytań diagnostycznych: czy ciężar środowiska leży w obszarach objętych dostępnymi scenariuszami, i czy tabele mieszczą się poniżej progów rekordów. Dwa razy „tak„ oznacza, że standard jest właściwą drogą, a praca skupia się na wyznaczeniu granic wiekowych i przygotowaniu procesów. Choć jedno „nie„ oznacza potrzebę podejścia alternatywnego.
Podejście SQL-owe: iteracyjne zadania zamiast data jobs na AOS
W ANEGIS zaprojektowaliśmy substytut standardowego rozwiązania, który może być wdrożony dla konkretnych klientów. Różnica tkwi w mechanice: tak jak standardowy Data Archive opiera się na data jobs, niskokosztowych zadaniach powiązanych z serwerami AOS, tak nasze rozwiązanie opiera się na małych zadaniach SQL-owych, które iteracyjnie wycinają konkretne partie rekordów. Iteracyjność jest tu sednem: zamiast jednej wielkiej operacji, która musi się zmieścić w progu i w oknie serwisowym, wykonuje się serię drobnych kroków o minimalnym wpływie na działające środowisko. Dzięki temu podejście działa również tam, gdzie standard się zatrzymuje, na tabelach największych, i pozwala dopasować zakres do obszarów, dla których standardowych scenariuszy brakuje.
Plan wdrożenia archiwizacji krok po kroku
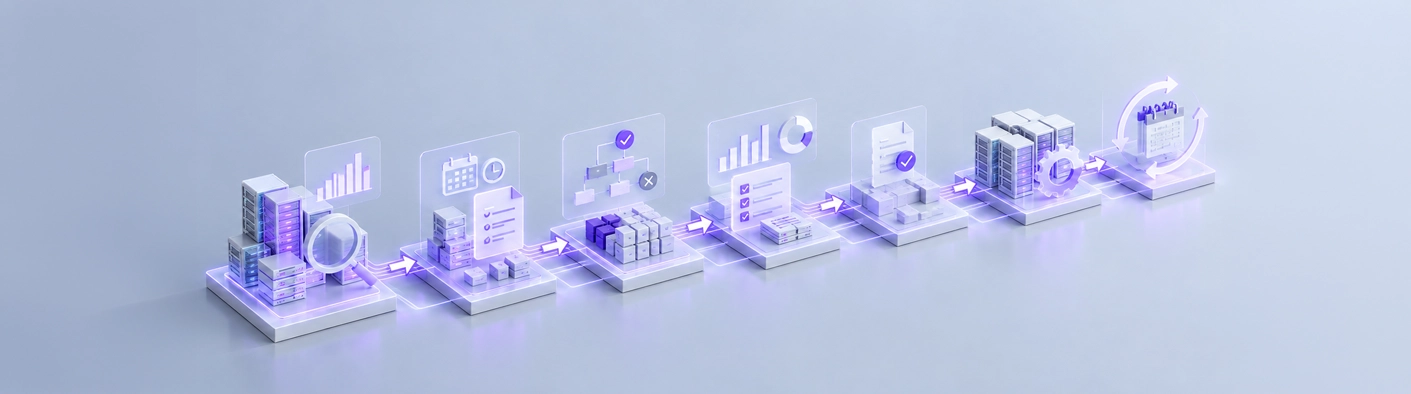
Niezależnie od wybranej mechaniki sekwencja wdrożenia jest wspólna. Najpierw analiza rozmiarów tabel na wiernej kopii produkcji, ona wskazuje, gdzie leży ciężar i które obszary w ogóle warto archiwizować. Następnie wyznaczenie granic wiekowych per obszar, wspólnie z księgowością i biznesem, to moment ustalenia magicznego N. Dalej weryfikacja wykonalności: czy dostępne scenariusze i progi obejmują wskazane obszary, czyli wybór między standardem a podejściem SQL-owym. Potem przejście procesów biznesowych i raportowych pod kątem wpływu zmian oraz pilotaż na środowisku testowym. Na końcu uruchomienie produkcyjne i, co odróżnia projekt od jednorazowej akcji, wpisanie archiwizacji w procedurę cykliczną, dzięki której kolejne roczniki danych będą opuszczać tabele operacyjne bez osobnego projektu za każdym razem.
Nie wiesz, czy Twoje tabele mieszczą się w progach standardu? Skontaktuj się z nami, wyślemy prostą instrukcję self-checku. Wystarczą zrzuty z Power Platform Admin Center i wynik skryptu SQL badającego rozmiary tabel na środowisku testowym, a przygotujemy estymację możliwych uzysków, rekomendację mechanizmu archiwizacji i ofertę fixed price na realizację.
FAQs
Jak działa Microsoft Data Archive w Dynamics 365 F&O?
W trzech krokach: dane z tabel operacyjnych (live) są przenoszone do tabel z sufiksem Archive, orientacyjnie dane w wieku 2–5 lat; następnie z tabel Archive do mechanizmu Long Term Data Retention w Dataverse, dane 5–N lat; wreszcie dane najstarsze, powyżej granicy N, są czyszczone. Granica N jest specyficzna dla każdego klienta i każdego obszaru danych osobno.
Dlaczego scenariusz Data Archive może się nie uruchomić?
Mechanizm funkcjonuje dla ograniczonej puli rekordów w konkretnych tabelach, progi należy rozumieć jako rząd stu czy dwustu milionów rekordów. Po przekroczeniu progu scenariusz po prostu się nie wykona, co paradoksalnie wyklucza z użycia tabele największe, czyli te najbardziej potrzebujące archiwizacji.
Czy Data Archive obejmuje wszystkie dane w D365FO?
Nie, dodatek funkcjonuje dla ograniczonej puli standardowych scenariuszy, choć grupa produktowa Microsoftu stale pracuje nad dodawaniem kolejnych. Jeżeli ciężar środowiska leży w obszarach nieobjętych scenariuszami, standardowa archiwizacja go nie zdejmie i potrzebne jest podejście alternatywne.
Co zrobić, gdy standardowa archiwizacja nie wystarcza?
Zastosować substytut oparty na małych, iteracyjnych zadaniach SQL-owych, które wycinają kolejne partie rekordów zamiast jednej wielkiej operacji, w odróżnieniu od standardu opartego na data jobs powiązanych z serwerami AOS. Podejście iteracyjne działa również na tabelach powyżej progów rekordów i pozwala objąć obszary, dla których standardowych scenariuszy brakuje, przy minimalnym wpływie na działające środowisko.
Od jakiego wieku środowiska warto wdrożyć archiwizację?
Praktyczną granicą są około dwa lata działania środowiska produkcyjnego, wcześniej nie ma jeszcze roczników danych kwalifikujących się do przeniesienia. W środowiskach starszych archiwizacja staje się głównym mechanizmem redukcji, bo znaczną część ciężaru stanowią pełnoprawne dane biznesowe, których nie wolno skasować, a które nie muszą mieszkać w tabelach operacyjnych.



Szukasz partnera Microsoft? Porozmawiajmy o Twoim projekcie
Pracuj z zespołem, który zrealizował wdrożenia i projekty dla dziesiątek firm. Umów rozmowę wstępną i sprawdź:
Jak Dynamics 365 dopasować do procesów Twojej firmy, a nie odwrotnie
Które obszary warto zautomatyzować, żeby odzyskać czas i obniżyć koszty
Jak wygląda wdrożenie z Anegis krok po kroku: od analizy po wsparcie po starcie